Sześć dni z agentami, 14 do 20 miesięcy dla ludzi.
Analiza nakładu pracy przy Proven, open-source'owym reviewerze kodu, który jedna osoba i flota agentów AI zbudowały na Open Agent Hackathon w październiku 2026. Zmierzyliśmy, co powstało, a potem czterema opublikowanymi metodami oszacowaliśmy, ile to samo zajęłoby zwykłemu zespołowi. Każdą liczbę można sprawdzić w publicznym repozytorium.
Przeczytaj raport (PDF po angielsku) →Repozytorium w zmierzonym tagu →
Porównanie
| Zbudowała flota agentów | Szacunek dla zespołu ludzi | |
|---|---|---|
| Czas kalendarzowy | Zbudowała flota agentów139 godzin, od pierwszego commita budowy do zgłoszenia | Szacunek dla zespołu ludzi14 do 20 miesięcy |
| Ludzie | Zbudowała flota agentów1 właściciel, który decyduje i merguje, a nie pisze kodu, oraz flota agentów AI | Szacunek dla zespołu ludzi9 do 11 osób na pełen etat w 8 rolach |
| Nakład | Zbudowała flota agentównieporównywalny w osobomiesiącach | Szacunek dla zespołu ludzi100 do 225 osobomiesięcy, szacunek centralny 135 do 180 |
| Kod produkcyjny | Zbudowała flota agentów42 036 linii Go oraz 9 246 linii shell, TypeScript, Python i SQL | Szacunek dla zespołu ludziten sam zakres |
| Testy | Zbudowała flota agentów58 956 linii Go, 1 828 funkcji testowych | Szacunek dla zespołu ludziten sam zakres |
| Rekord | Zbudowała flota agentów53 ADR; 307 werdyktów w 154 niezależnych review, w tym 113 odrzuceń | Szacunek dla zespołu ludzizwykle częściowy: komentarze w pull requestach i tickety |
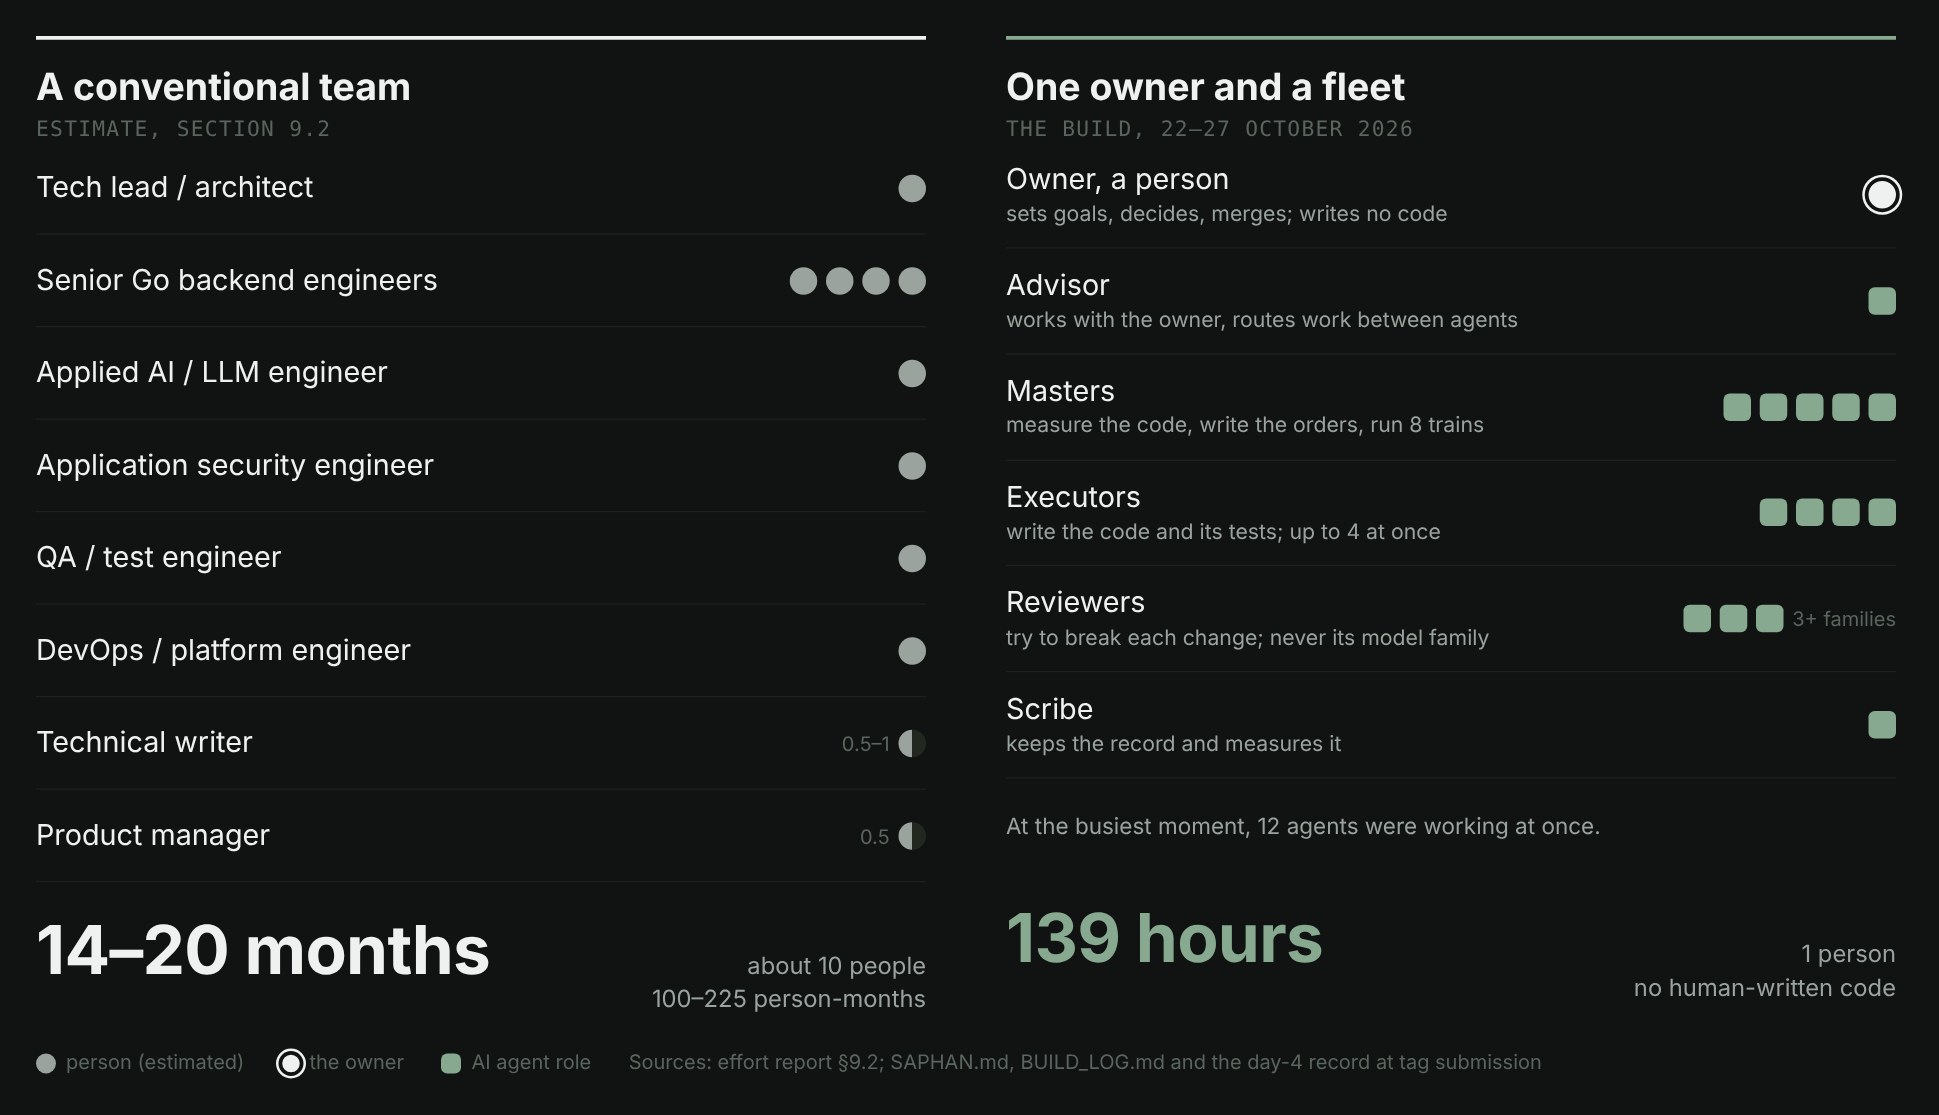
Szacunek pochodzi z COCOMO II, bazy ukończonych projektów QSM, przedziałów produktywności Steve'a McConnella i liczenia oddolnego według pakietów pracy. Porównanie dotyczy czasu kalendarzowego i zakresu, a nie tego, czy agenci są lepszymi programistami.
Jakość kodu wobec opublikowanych punktów odniesienia
Pokrycie testami: 80,9%
Powyżej 75%, czyli poziomu 4 w dobrowolnych poziomach pokrycia Google (Ivanković i in., 2019). Zmierzone na pakietach, które zawierają 64% kodu produkcyjnego; raport wyjaśnia dlaczego.
Udokumentowane publiczne API: 96,1%
1 490 z 1 550 eksportowanych identyfikatorów Go ma komentarz dokumentacyjny. Wytyczne Go wymagają go przy każdym.
Gęstość komentarzy: 18,7%
Średnia z ponad 5 000 projektów open source to 18,67% (Arafat i Riehle, 2009).
Złożoność: 88,9% funkcji na poziomie 10 lub niżej
Limit McCabe'a na funkcję (NIST SP 500-235). Jeden znany wyjątek, opisany w README w sekcji Honest limits.
Czego to porównanie nie twierdzi
Linie kodu mierzą rozmiar, nie wartość.
Modele estymacji skalibrowano na projektach ludzi; użycie ich tutaj zakłada, że ten sam zakres oznacza ten sam rozmiar.
Równa jakość nie jest udowodniona.
README wymienia otwarte ograniczenia. Zespół ludzi mógłby dostarczyć mniej funkcji z mniejszą liczbą znanych ograniczeń.
Sześć dni to nie cały wysiłek.
Temat i 25 decyzji projektowych powstały w planowaniu 16–21 października, a flota działa na Saphan Studio, zbudowanym przed hackathonem.
Nie wszystko jest zmierzone.
Godzin pracy właściciela nie ma w rekordzie, a ta publiczna wersja nie podaje kwot za budowę przez agentów.
Sprawdź sam
Sekcja 11 raportu podaje komendy do każdej liczby: sklonuj repozytorium, przejdź na tag submission i policz. Zacznij od sekcji Honest limits w README, a potem hackathon/fleet/LEDGER.md: każda zmiana, model, który ją zbudował, jej rundy i warunki.
Więcej o Saphan Studio
Badania — agenci AI w prawdziwej pracy →Governance — decyzje w rekordzie →Protokół — jak pracuje flota →
Pytania o metodę albo chcesz takiego pomiaru dla pracy swojego zespołu?
Napisz do nas — [email protected]