หกวันกับเอเจนต์ 14 ถึง 20 เดือนสำหรับคน
การวิเคราะห์ความพยายามของ Proven เครื่องมือรีวิวโค้ดโอเพนซอร์สที่คนหนึ่งคนกับฝูงเอเจนต์เขียนโค้ด AI สร้างขึ้นในงาน Open Agent Hackathon เดือนตุลาคม 2026 เราวัดสิ่งที่ส่งมอบ แล้วใช้วิธีประมาณการที่ตีพิมพ์แล้วสี่วิธีประเมินว่าทีมทั่วไปต้องใช้เท่าไรในการสร้างสิ่งเดียวกัน ทุกตัวเลขตรวจสอบได้ในรีโพสิทอรีสาธารณะ
การเปรียบเทียบ
| สร้างโดยฝูงเอเจนต์ | ประมาณการสำหรับทีมคน | |
|---|---|---|
| เวลาตามปฏิทิน | สร้างโดยฝูงเอเจนต์139 ชั่วโมง ตั้งแต่คอมมิตแรกของการสร้างจนถึงการส่งผลงาน | ประมาณการสำหรับทีมคน14 ถึง 20 เดือน |
| คน | สร้างโดยฝูงเอเจนต์เจ้าของ 1 คนที่ตัดสินใจและ merge แต่ไม่เขียนโค้ด กับฝูงเอเจนต์ AI | ประมาณการสำหรับทีมคน9 ถึง 11 คนเต็มเวลาใน 8 บทบาท |
| ความพยายาม | สร้างโดยฝูงเอเจนต์เทียบเป็นคน-เดือนไม่ได้ | ประมาณการสำหรับทีมคน100 ถึง 225 คน-เดือน ค่ากลางประมาณ 135 ถึง 180 |
| โค้ดโปรดักชัน | สร้างโดยฝูงเอเจนต์Go 42,036 บรรทัด และ shell, TypeScript, Python, SQL อีก 9,246 บรรทัด | ประมาณการสำหรับทีมคนขอบเขตเดียวกัน |
| เทสต์ | สร้างโดยฝูงเอเจนต์Go 58,956 บรรทัด ฟังก์ชันเทสต์ 1,828 ฟังก์ชัน | ประมาณการสำหรับทีมคนขอบเขตเดียวกัน |
| บันทึก | สร้างโดยฝูงเอเจนต์ADR 53 ฉบับ; คำตัดสินรีวิว 307 รายการจากรีวิวอิสระ 154 ครั้ง ในจำนวนนี้ปฏิเสธ 113 รายการ | ประมาณการสำหรับทีมคนมักไม่ครบ: คอมเมนต์ใน pull request และทิกเก็ต |
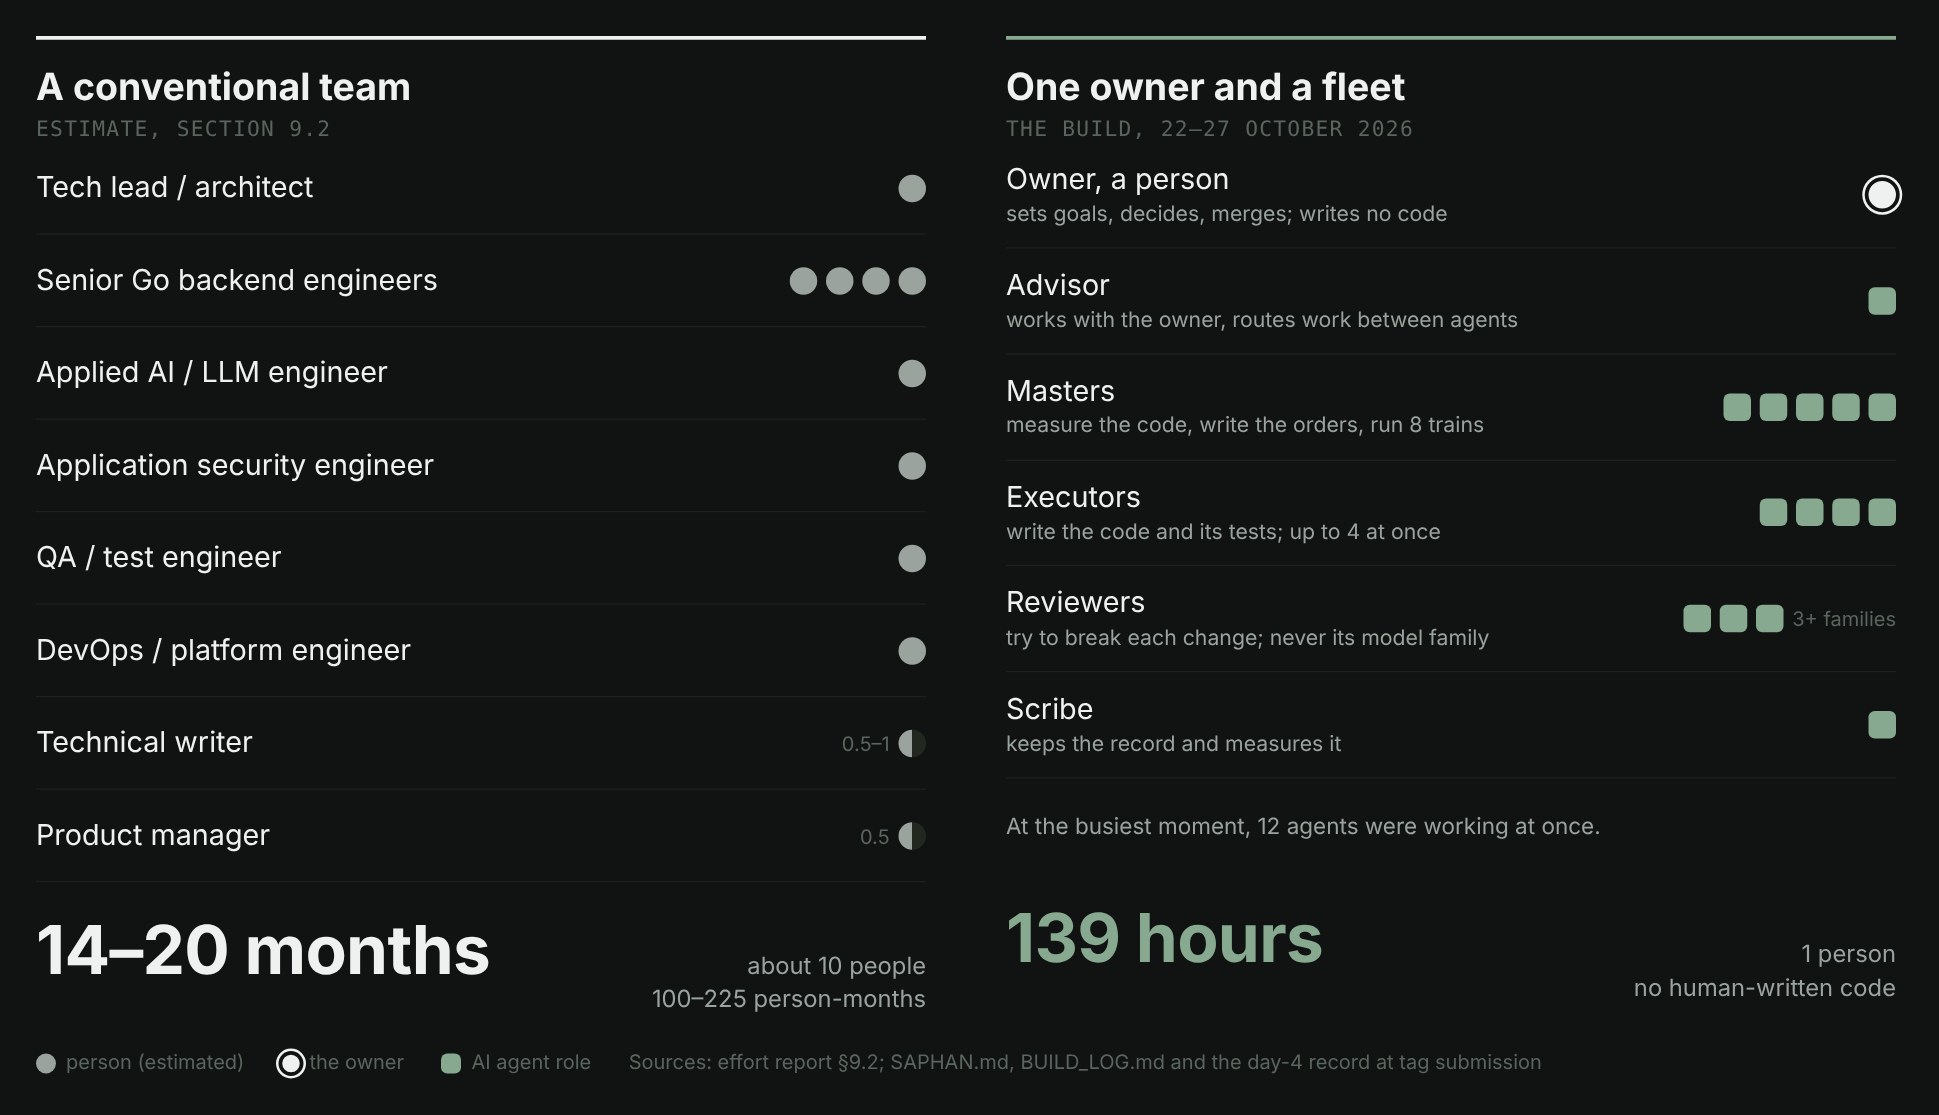
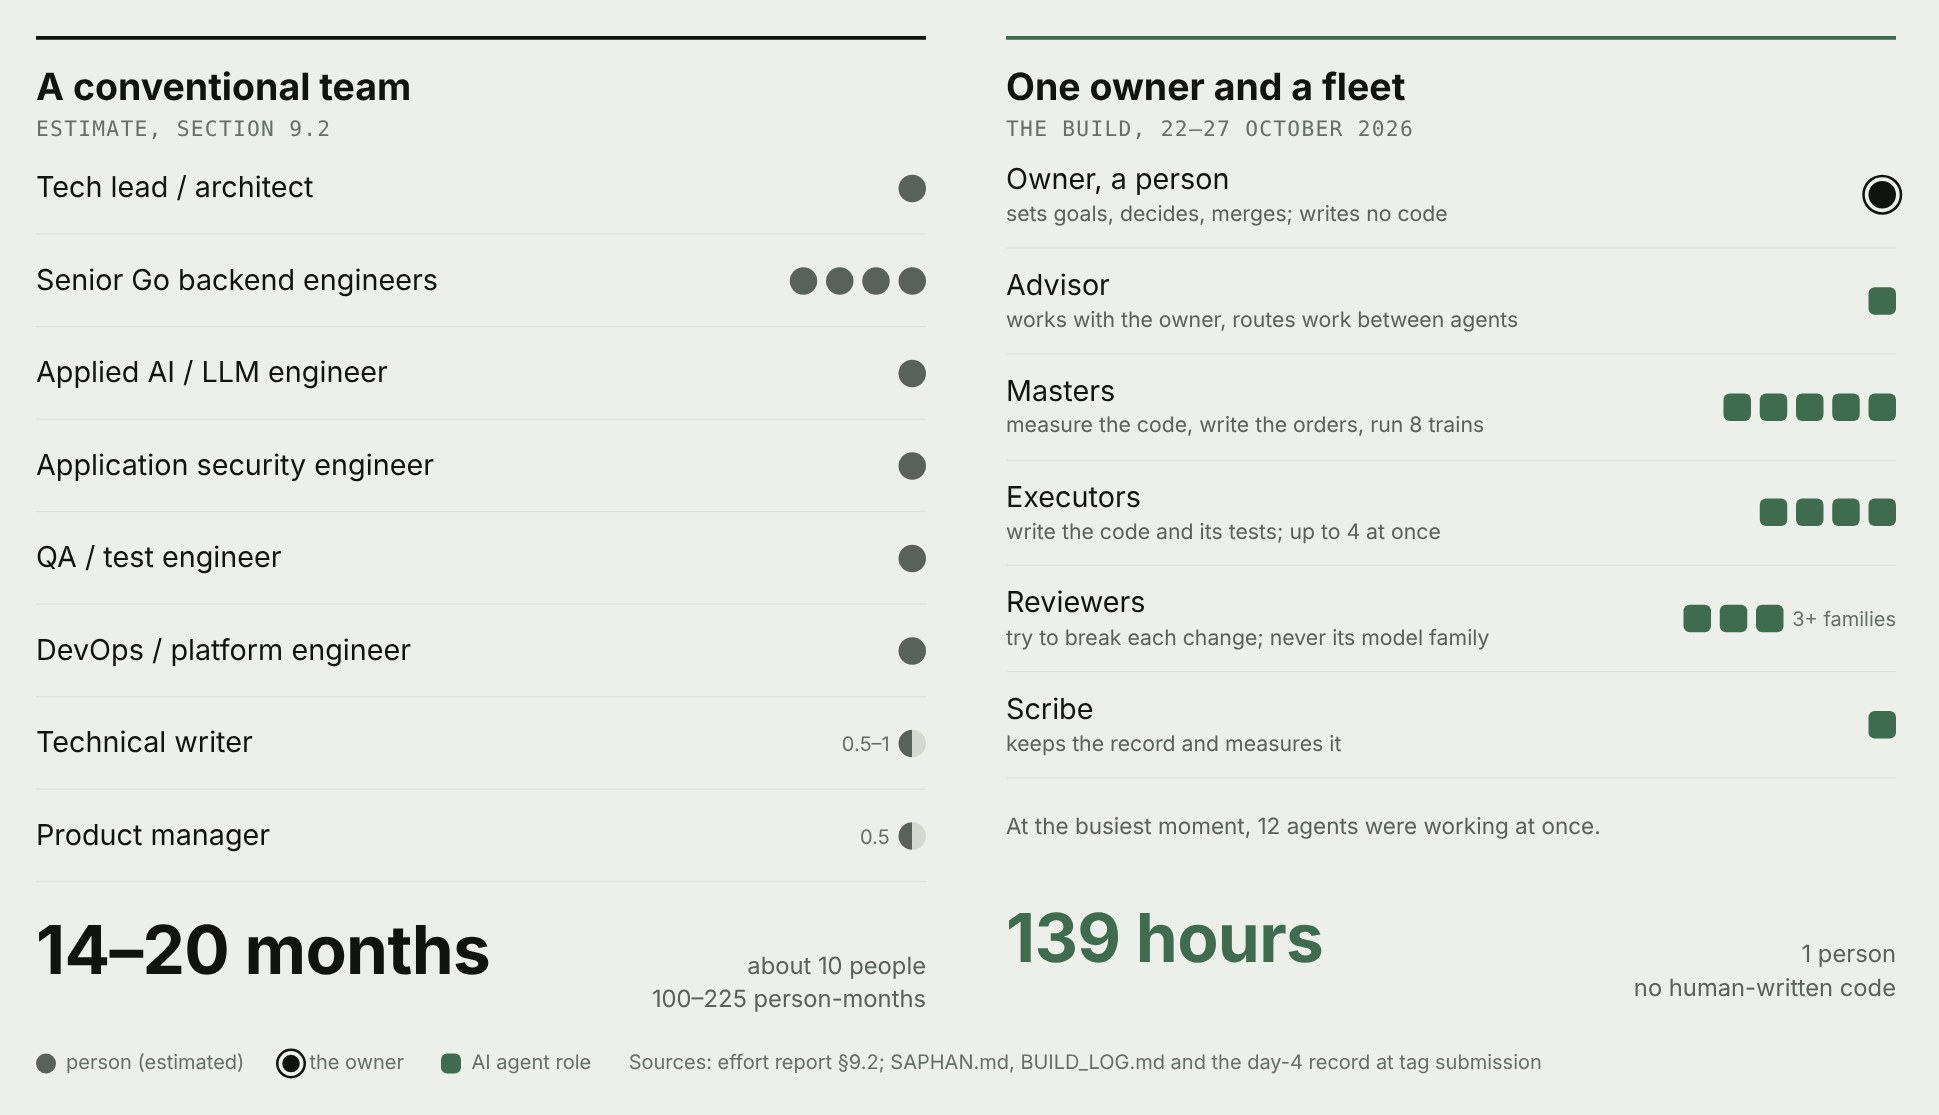
ค่าประมาณมาจาก COCOMO II ฐานข้อมูลโครงการที่เสร็จแล้วของ QSM ช่วงผลิตภาพของ Steve McConnell และการนับจากล่างขึ้นบนตามชุดงาน การเปรียบเทียบนี้เกี่ยวกับเวลาตามปฏิทินและขอบเขต ไม่ใช่ว่าเอเจนต์เป็นโปรแกรมเมอร์ที่เก่งกว่า
คุณภาพโค้ดเทียบกับเกณฑ์ที่ตีพิมพ์
ความครอบคลุมของเทสต์: 80.9%
สูงกว่า 75% ซึ่งเป็นระดับ 4 ในระดับความครอบคลุมแบบสมัครใจของ Google (Ivanković และคณะ, 2019) วัดบนแพ็กเกจที่มีโค้ดโปรดักชัน 64% รายงานอธิบายเหตุผลไว้
API สาธารณะที่มีเอกสาร: 96.1%
ตัวระบุ Go ที่ export แล้ว 1,490 จาก 1,550 มี doc comment แนวทางของ Go ขอให้มีทุกตัว
ความหนาแน่นของคอมเมนต์: 18.7%
ค่าเฉลี่ยจากโครงการโอเพนซอร์สกว่า 5,000 โครงการคือ 18.67% (Arafat และ Riehle, 2009)
ความซับซ้อน: 88.9% ของฟังก์ชันอยู่ที่ 10 หรือต่ำกว่า
ขีดจำกัดต่อฟังก์ชันของ McCabe (NIST SP 500-235) มีค่าผิดปกติที่ทราบหนึ่งรายการ ระบุไว้ใน README หัวข้อ Honest limits
สิ่งที่การเปรียบเทียบนี้ไม่ได้อ้าง
จำนวนบรรทัดวัดขนาด ไม่ใช่คุณค่า
แบบจำลองการประมาณการปรับเทียบจากโครงการของคน การใช้ที่นี่จึงสมมติว่าขอบเขตเดียวกันหมายถึงขนาดเดียวกัน
ยังไม่ได้พิสูจน์ว่าคุณภาพเท่ากัน
README ระบุข้อจำกัดที่ยังเปิดอยู่ ทีมคนอาจส่งมอบฟีเจอร์น้อยกว่าแต่มีข้อจำกัดที่ทราบน้อยกว่า
หกวันไม่ใช่ความพยายามทั้งหมด
หัวข้อและการตัดสินใจด้านการออกแบบ 25 ข้อมาจากการวางแผนวันที่ 16 ถึง 21 ตุลาคม และฝูงเอเจนต์ทำงานบน Saphan Studio ที่สร้างก่อนแฮกกาธอน
ไม่ใช่ทุกอย่างถูกวัด
ชั่วโมงทำงานของเจ้าของไม่อยู่ในบันทึก และฉบับสาธารณะนี้ไม่เผยแพร่ตัวเลขค่าใช้จ่ายของการสร้างโดยเอเจนต์
ตรวจสอบด้วยตัวเอง
หัวข้อ 11 ของรายงานให้คำสั่งสำหรับทุกตัวเลข: โคลนรีโพสิทอรี เช็กเอาต์แท็ก submission แล้วนับ เริ่มจากหัวข้อ Honest limits ใน README แล้วต่อด้วย hackathon/fleet/LEDGER.md: ทุกการเปลี่ยนแปลง โมเดลที่สร้าง รอบ และเงื่อนไข
Saphan Studio เพิ่มเติม
งานวิจัย — ศึกษาเอเจนต์ AI ในงานจริง →Governance — การตัดสินใจที่มีบันทึก →โปรโตคอล — ฝูงเอเจนต์ทำงานอย่างไร →
มีคำถามเรื่องวิธีการ หรืออยากวัดแบบเดียวกันกับงานของทีมคุณ?
ติดต่อเรา — [email protected]